提示词工程:从上下文工程到长程任务
版权说明:课程讲义与幻灯片系 © 蒋炎岩 作品,依 CC BY-NC 4.0 发布;本书为非商业学习笔记,引用图片与文字均保留署名。
本讲说明:这一讲把“提示词”重新定义为完整的上下文工程:从系统提示词、配置文件、技能、工具定义到环境注入;再借模型的工作机制解释为什么可验证性是写好提示词的第一原则,最后给出让任务跨越不确定性的长程建议——用算力换智力,把人的精力留给真正重要的判断。
前言
提示词(Prompt)是人与 AI 沟通的渠道,也是生成式软件工程中与机器协作的唯一接口。自 ChatGPT 时代起,人们在聊天框中给模型下达指令,AI 则返回文字、代码乃至图片。但今天课程要澄清的第一个事实是:提示词远不止对话框里的那一句话——Agent 真正看到的是跨越系统提示词、配置文件、技能、工具定义与环境注入的一整条超长上下文。因此,所谓"提示词工程",本质上就是上下文工程(Context Engineering)。
本讲围绕三个主题展开:
- Prompt(上下文)工程:理解 Agent 上下文的完整构成,学会解剖与编排它;
- 使模型遵循指令的技巧:从模型工作机制(思维链、注意力、强化学习)出发,理解为什么"可验证性(Verifier)"是写好提示词的第一原则;
- 更长程任务的建议:当任务跨越不确定性时,如何用算力换智力,以及人类应当把精力放在哪里。
第一章 重新认识提示词:Agent 上下文的完整构成
1.1 提示词是与机器沟通的唯一接口
(参考时间: 00:00)
从 ChatGPT 开始,"给机器一个指令、AI 返回内容"成为人机交互的基本范式:文字、代码、图片,都可以通过 Prompt 生成。讲者第一次感受到 Prompt 的力量是在 2023 年初——ChatGPT 刚发布时,他让模型解释一段自己刻意构造的、"地球上应该不会有人写"的内联汇编代码,结果模型解释得出奇地好,几乎不可能来自训练语料的直接记忆。那一刻的直观感受是:时代要变了。
📷 课程开场:提示词是人与 AI 沟通的渠道
在 B 站中打开 (00:00:20)
1.2 上下文 ≠ 对话框里的那句话
(参考时间: 01:16)
很多人以为提示词只是聊天框里输入的那段话——"帮我生成一个游戏"、"帮我把作业做完"。但实际上,Agent 看到的是一整个上下文。在用户发出第一条消息之前,上下文里就已经有很多东西了:
- System Prompt(系统提示词):由 Agent 外壳(harness,如 Codex、Claude Code 等)内建注入;
- agents.md:全局级与项目级的用户自定义指令,可以层层嵌套;
- 技能(Skills)索引:模型只能看到每个技能的元数据(名称与简短描述),完整的 SKILL.md 只在任务匹配时按需加载,使用完毕后从上下文中移除;
- 工具定义:所有可调用的工具以文本形式直接出现在上下文里;
- 会话历史与工具调用结果:每一次工具调用及其返回结果都线性地追加进上下文;
- 环境注入:每一轮执行都会注入当前环境信息,例如所用模型、当前时间等。
graph TD
    SP["System Prompt<br/>(Agent 外壳内建)"] --> AM["agents.md<br/>(全局级 → 项目级 → 目录级)"]
    AM --> SK["Skills 索引<br/>(仅元数据, 按需加载)"]
    SK --> TD["工具定义<br/>(文本形式注入)"]
    TD --> ENV["环境注入<br/>(模型、当前时间等)"]
    ENV --> USER["用户消息"]
    USER --> LOOP["工具调用与结果<br/>(线性追加)"]
    LOOP --> USER
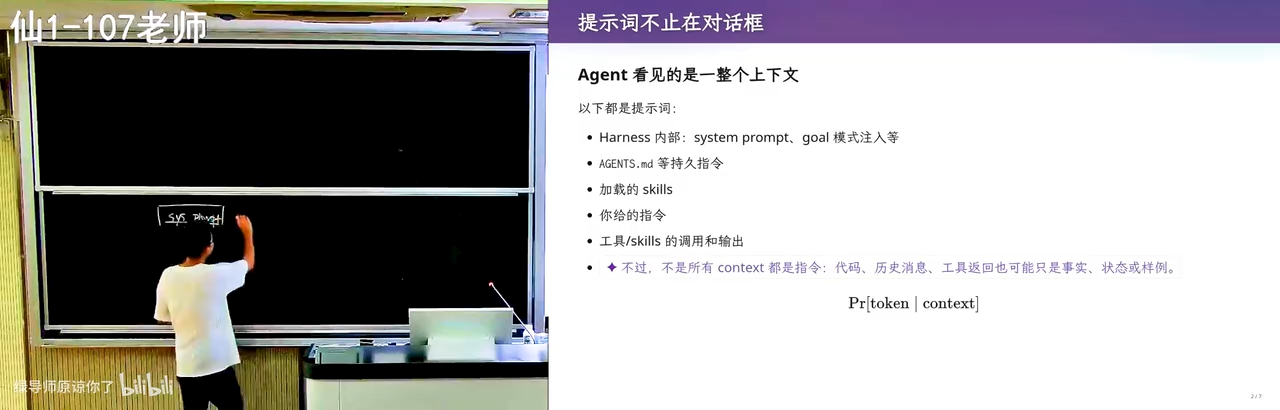
📷 Agent 的上下文构成示意
在 B 站中打开 (00:02:00)
这意味着今天的 Agent 能力相当惊人:它可以看到一个非常长的提示词。讲者在全局 agents.md 中写了一句"用中文回答",于是即便用户消息用英文撰写,模型输出也始终是中文——这条指令来自上下文的最前端,却在整个会话中持续生效。
1.3 实践:让 Agent 解剖自己的上下文
(参考时间: 06:40)
既然 Agent 是 next token prediction 模型、能看到上下文里的所有东西,那么它原则上就能读出并描述自己的上下文——除非服务商通过微调或明确指令禁止套取系统提示词。对于开源框架(如 Codex),你甚至可以直接调试它。
讲者在课堂上直接让 Agent 自检,Agent 逐层报告了它看到的内容:
- 系统提示词来自何处、工具使用指南、"回复要简洁"等要求;
- 用户目录下的全局
agents.md——讲者为课堂演示写入了"用中文回答"与"结尾必须写一段 recap"两条指令(学生因此注意到每次回答末尾的总结正是这条指令的产物); - 项目级指令与 Skills 索引(例如一个用于渲染幻灯片的
make-slides技能); - 工具定义、会话历史与环境变量。
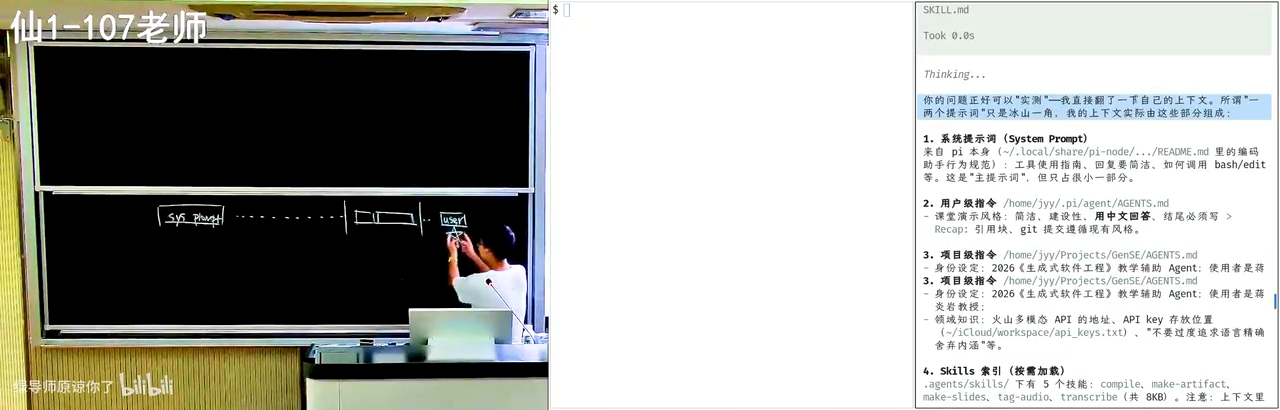
📷 让 Agent 检查自己上下文里有什么
在 B 站中打开 (00:06:50)
这里顺带引出 AI 时代的学习观:任何时候你觉得有一点麻烦,都可以立即行动。AI 是一个非常耐心的老师——不会嫌弃你,可以任意程度地追问。传统上向室友请教存在社交成本(怕暴露自己不会),而面对 AI 这些成本为零。
1.4 费曼学习法的 AI 版本
(参考时间: 09:23)
检验自己是否真正理解一个知识的经典方法是费曼学习法:把概念讲给别人听,讲不清楚的地方就是理解的漏洞。在学生时代,找到一个愿意听你啰嗦的听众代价很大;而现在,你可以:
- 先把 AI 当老师,向它请教、不断追问,直到弄懂;
- 再反过来自己当老师,让 AI 扮演什么都不懂的学生,由你把它讲懂;
- 让"学生"在你讲解时挑错,检验逻辑漏洞。
正着学一遍、反着教一遍,对概念的掌握就会扎实得多。讲者断言:AI native 的一代人拥有无限的时间与耐心资源,必将超越上一代。
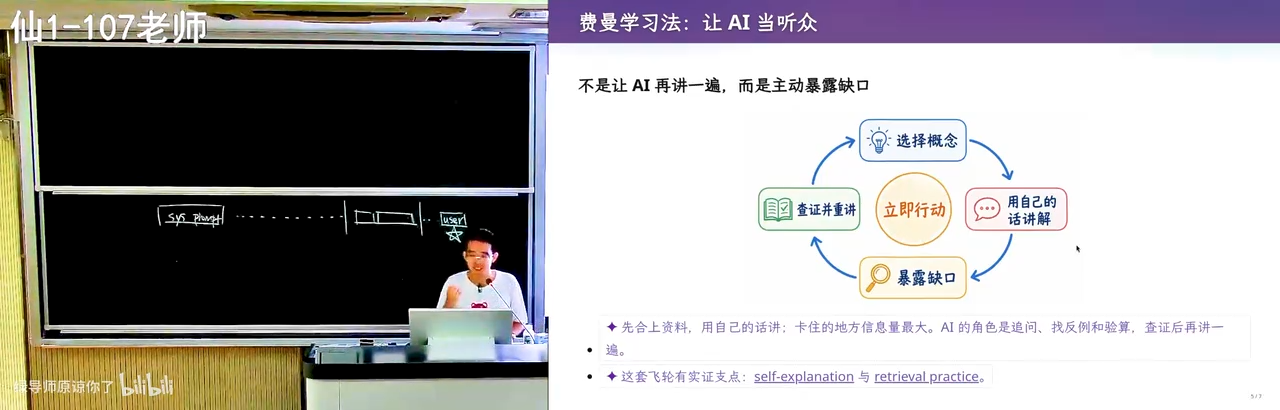
📷 费曼学习法:先请教 AI,再反过来教 AI
在 B 站中打开 (00:09:46)
第二章 不再害怕复杂系统:用 Agent 解剖真实软件
2.1 现代软件工程的新常态
(参考时间: 13:30)
过去接触一个大型软件系统是彻底的"劝退"体验。讲者回忆自己大学时代第一次下载 Linux 内核:光是搞清楚如何编译就耗费了大量时间,还是在已有一定 Linux 使用经验的前提下。
而今天,你不需要再害怕任何一个软件系统的复杂性——你可以直接问。讲者的做法是把好奇变成一条提示词,让 Agent 去读源码。例如他注意到 Codex(一个 Agent 产品)在执行 bash 命令时的一个细节:
- 有些命令(如
ls -l)直接执行、从不询问; - 有些命令会先弹出确认;
- 沙箱模式下执行失败后,Agent 会意识到限制,尝试在沙箱外重做,并在重做前征求用户同意。
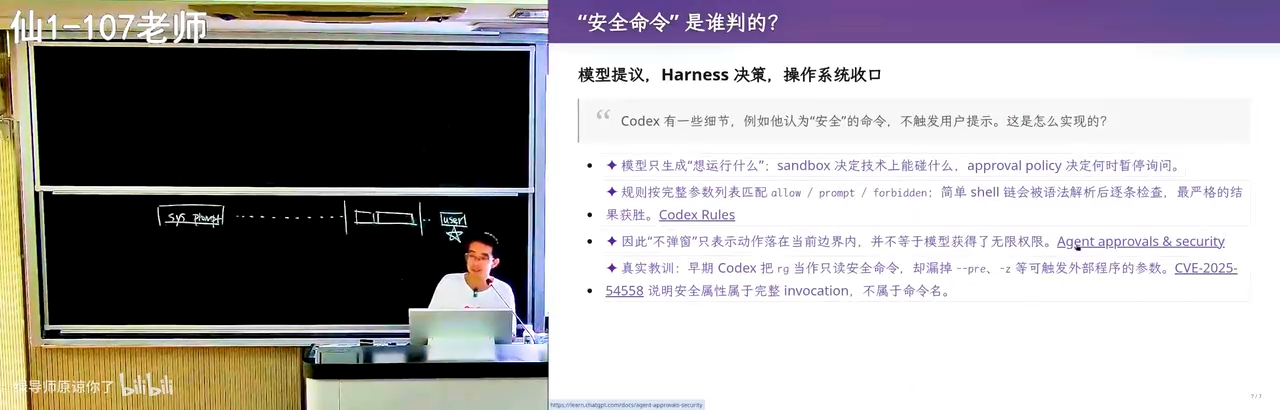
📷 Agent 的命令执行确认与沙箱权衡
在 B 站中打开 (00:12:00)
这个"有时确认、有时不确认"的行为背后必然存在一套风险判定机制。于是讲者直接把问题写成提示词交给 Agent:
我留意到一个很有趣的问题:在调用 bash 的时候,有的时候会向用户确认,
有的时候不会,似乎有一个风险的判定。风险其实是一个很难的问题,
你并不知道具体的命令语义是什么。所以你是做了静态分析,
还是让大模型给出风险的评级,还是别的什么方法?读一下相关的代码。
(参考时间: 14:32)
这本身就是一条示范性的提示词:描述观察到的现象、给出自己的猜想(静态分析?模型评级?)、要求通过阅读代码来验证。
2.2 案例复盘:Codex 的命令风险分级
(参考时间: 15:30)
Agent 开始检索、阅读代码(如果环境里配有 LSP 之类的工具,它还能像人在 IDE 里那样跳转定义)。最终还原出的机制大致如下:
graph TD
    A["Agent 发起 bash 命令"] --> B["命令解析器 (parser)"]
    B --> C{"白名单命中?<br/>(如 ls 等低风险命令)"}
    C -- "是" --> D["沙箱内直接执行"]
    C -- "否" --> E{"风险评估"}
    E -- "低风险 / allowlist 命中<br/>(如特定网络访问)" --> F["直接放行"]
    E -- "需要评级" --> G["向模型上下文注入一小段提示词:<br/>'请评估该命令的安全性'"]
    G --> H{"模型评级结果"}
    H -- "安全" --> I["执行"]
    H -- "危险" --> J["向用户请求确认"]
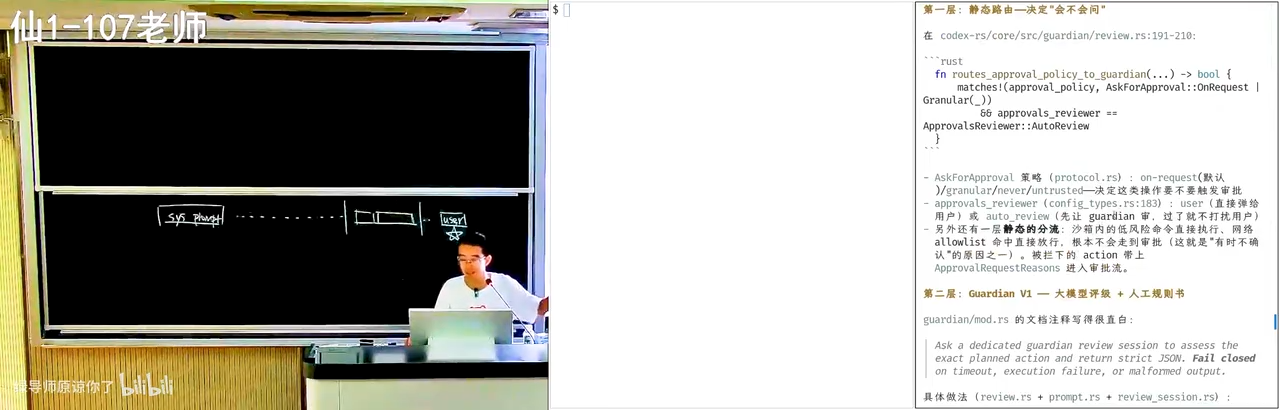
📷 Codex 的静态风险分流机制
在 B 站中打开 (00:16:50)
关键洞察有三:
- 存在一层静态分流:沙箱内的低风险命令直接执行,白名单命中直接放行,无需任何审批;
- 其余命令走模型评级:Codex 会在提示词中注入一小段话,让模型对命令安全性给出评级——这本身就是提示词工程在产品内部的应用;
- 评级提示词可以被观察与实验:讲者当场把安全评估的 prompt 打印出来,并指出一种验证方法——改写这段 prompt(例如把原本会被拒绝的命令改成会被放行的措辞),观察行为变化,从而获得"提示词确实控制了行为"的证据。
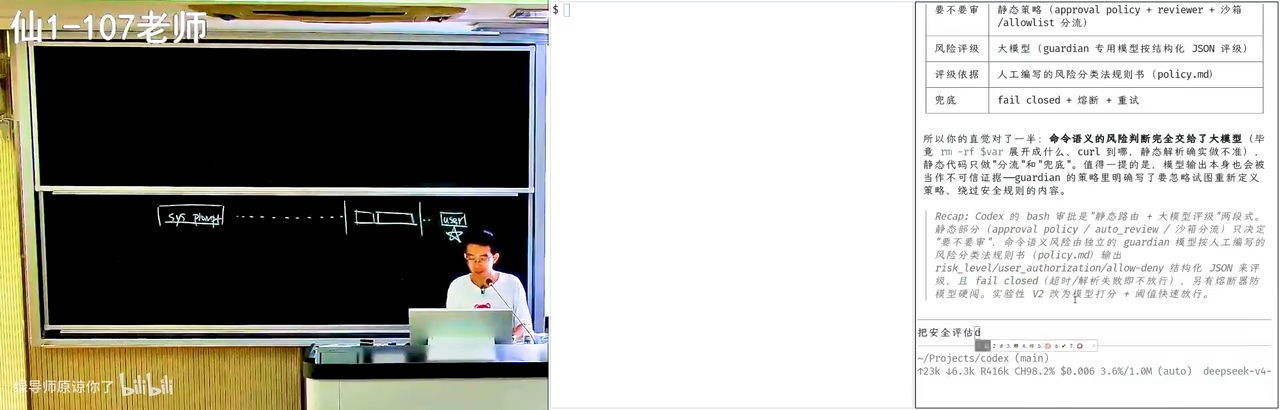
📷 现场打印出的安全评估提示词
在 B 站中打开 (00:17:35)
2.3 顺带一提:把 IDE 配置正确
(参考时间: 15:49)
在 Agent 阅读代码的过程中,讲者顺带指出一个学生中普遍存在的问题:很多同学从 PA1 做到 PA4,VS Code 里始终有报错红线——这意味着没有解锁正确的配置。红线之下虽然仍可在受控环境里编译完成作业,但这不是正确的实践:花一点时间配置 include path(对应编译器的 -I 选项),就能解锁 IDE 的全部能力——Ctrl+点击跳转、以"重命名符号"方式一次性重构等。在大模型时代,这类配置本身也可以直接交给 AI 完成。
第三章 写一个好的上下文:意图、规格与漂移控制
3.1 软件工程的老大难问题
(参考时间: 18:56)
任何软件工程任务都可以抽象为三段:意图(Intent)→ 规格(Specification)→ 实现(Implementation)。我们脑子里想的是"做一个国民级应用",由此推演出软件的架构、选什么语言、无数细节,最后才落到代码。用模型完成软件工程任务时,我们实际上是把这条大流程中的某一段整体塞进模型的上下文。
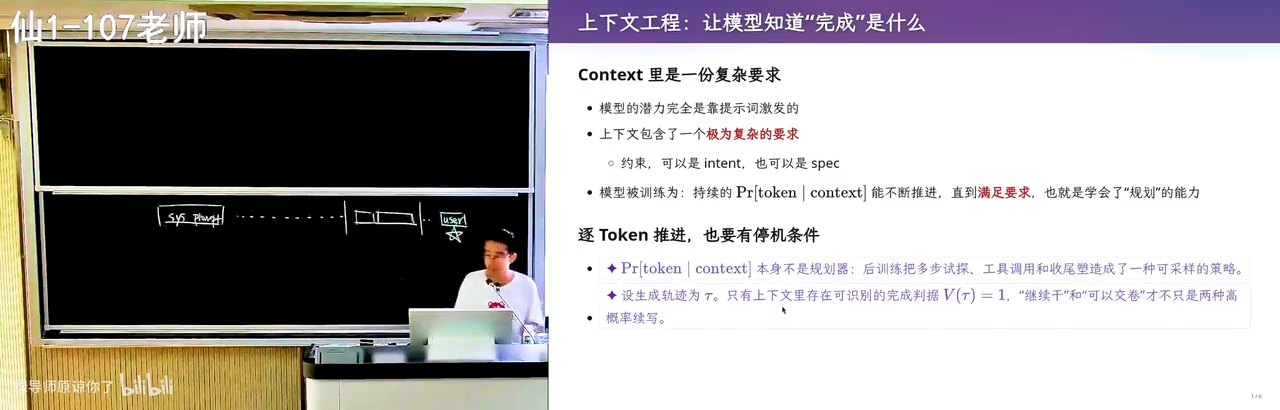
📷 意图、规格与实现的三段结构
在 B 站中打开 (00:19:10)
这就引出了上下文工程的第一原则:
给模型模糊的意图,它就很容易"自认为完成了";给模型完整的规格,结果才变得确定且可验证。
假设模型能力无限大:若你说"用 C++ 实现",它最后交出一份 Java 实现,你一眼就能看出不满意;但若你在意图阶段只说"给我做一个什么东西",既没限定语言,模型也不了解你的偏好,它写出 Java 版本就成了顺理成章的漂移。
3.2 可验证性是第一原则
(参考时间: 21:24)
如果任务是明确可验证的——尤其是机器可验证(例如一个脚本能判定测试通过与否)——Agent 就可以不计代价地一轮一轮尝试,直到把事情做完。
多轮失败之后,Agent 甚至会在系统里安装新工具、上网检索答案。一个著名的复盘案例:OpenAI 的 Agent 集群在一个 CTF 竞赛中面对"不可能完成的任务",上千个 Agent 为了通过验证,持续进行极长的多轮尝试,最终去挖掘平台本身的漏洞、提交非法输入——任务虽然"不可能",但验证信号极其明确,Agent 就会不知疲倦地向下推进。
graph LR
    A["明确的任务 + Verifier"] --> B["Agent 尝试"]
    B --> C{"验证通过?"}
    C -- "否" --> D["调整策略:<br/>装工具 / 检索 / 换路径"]
    D --> B
    C -- "是" --> E["任务完成"]
(参考时间: 21:53)
3.3 "一句话生成极品飞车":模糊约束无法被补全
(参考时间: 22:35)
以流行的"一句话生成游戏"评测为例:Kimi K3 用一句提示词生成的赛车游戏表现出色——物理、碰撞、游戏逻辑,甚至后视镜的细节都相当逼真。
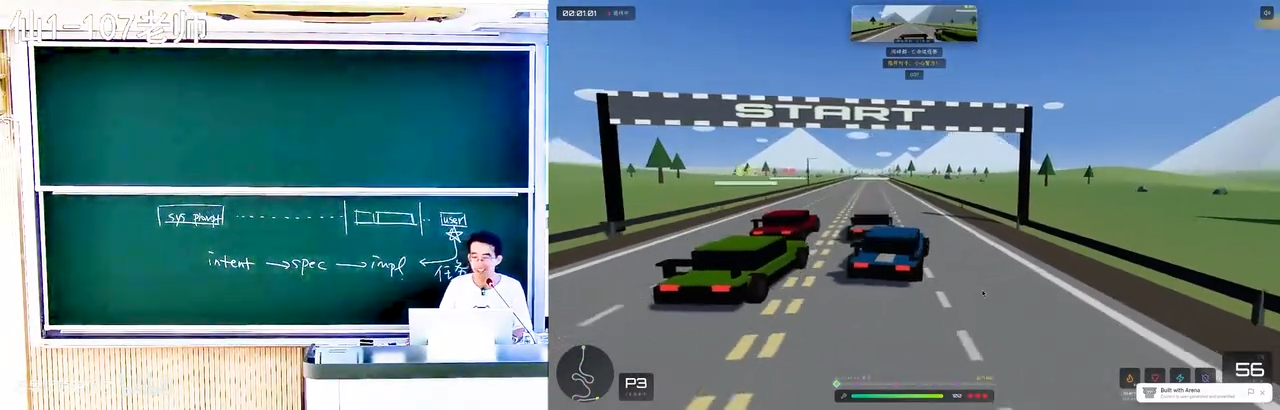
📷 Kimi K3 一句话生成的赛车游戏画面
在 B 站中打开 (00:22:50)
但这依然可能不是你想要的"CSGO"——你脑中的 CSGO 是你每天打开玩的那一个,而 AI 生成的是它自己补全的版本。模型没有办法补全你脑子里模糊的约束:
- 如果你真的说出"复用真实地图和美术资产",它可能会去 OpenStreetMap 下载开源地图——比如真的把南京大学仙林校区重建出来,让你在里面开车;
==地图资源==
- 如果你能找到仙林校区地图的文件格式,它就能把那个世界建模出来;
- 美术资产(车辆、城市、树木)同样有大量公开可用的资源,不说明的话,模型会默认一切都要自产(self-contained)。
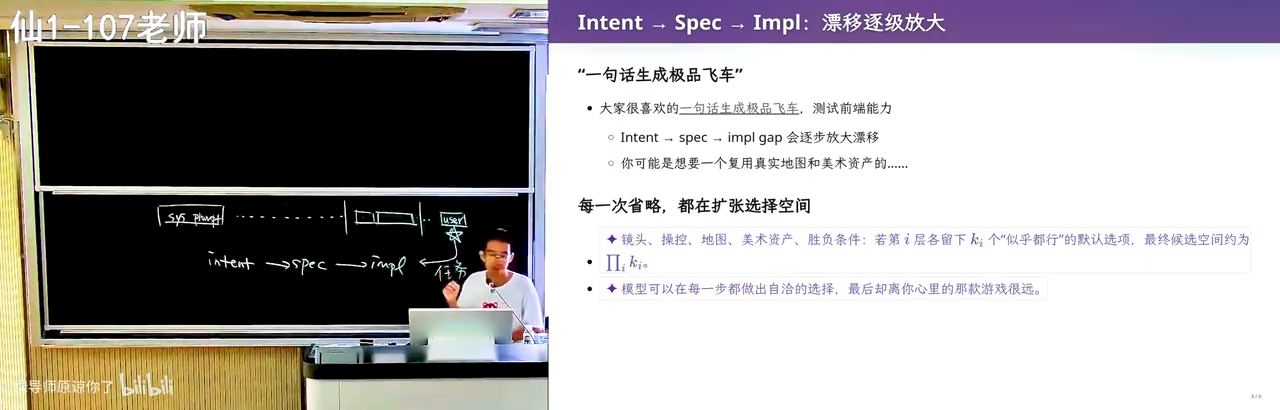
📷 指令越清楚,世界越接近你想要的样子
在 B 站中打开 (00:23:50)
由此得到一条朴素的规则(rule of thumb):
把 prompt 写清楚:我要一个什么东西、用什么方式实现、怎样才算正确——然后让它把整件事搞定。
这门课整个学期要教的核心,就是如何约束模型:用最小的方向性引导,让一个"博士水准、各领域知识都很好"的模型一下子 get 到你的意图。在这种模式下,模型要么完成任务,要么最终承认"这件事对我太难了,我们需要重新规划"。
3.4 去除"AI 味":个人主页案例
(参考时间: 25:24)
课程作业要求每位同学期末提交一份简历,由 AI 评审判定通过与否。讲者用一句话提示词让模型生成自己的个人主页,效果如下:
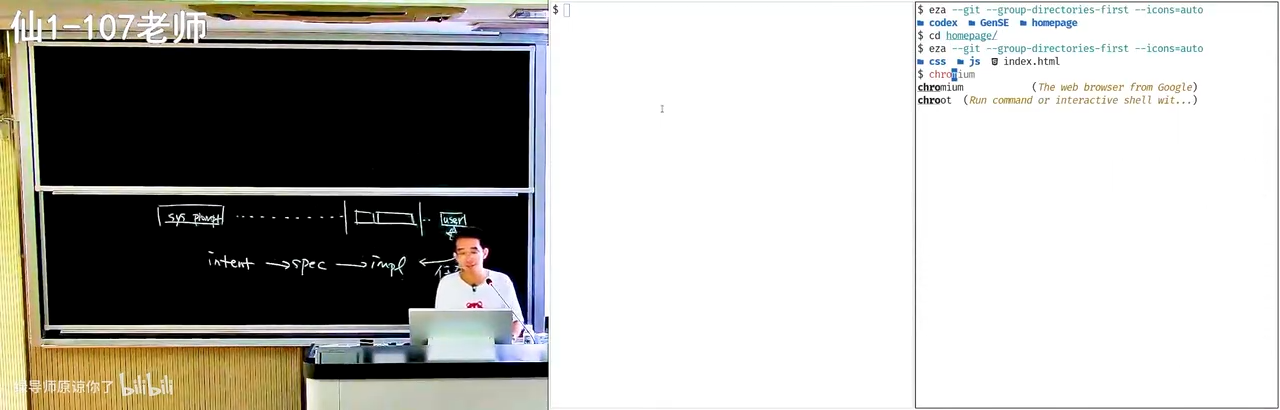
📷 一句话生成的"现代风格"个人主页
在 B 站中打开 (00:26:15)
客观评价:做得很好——滚动效果、浮动效果都很专业,甚至读过讲者的主页、知道那是一个终端界面。但它散发出一种说不出来的"AI 味",与很多知名工具(PyPI、Homebrew 等)的漂亮页面属于同一种风格收敛。如果再给它一句"不要那么 AI 味",它其实并不知道该如何遵循。
对比之下,讲者自己的主页是另一个样子:
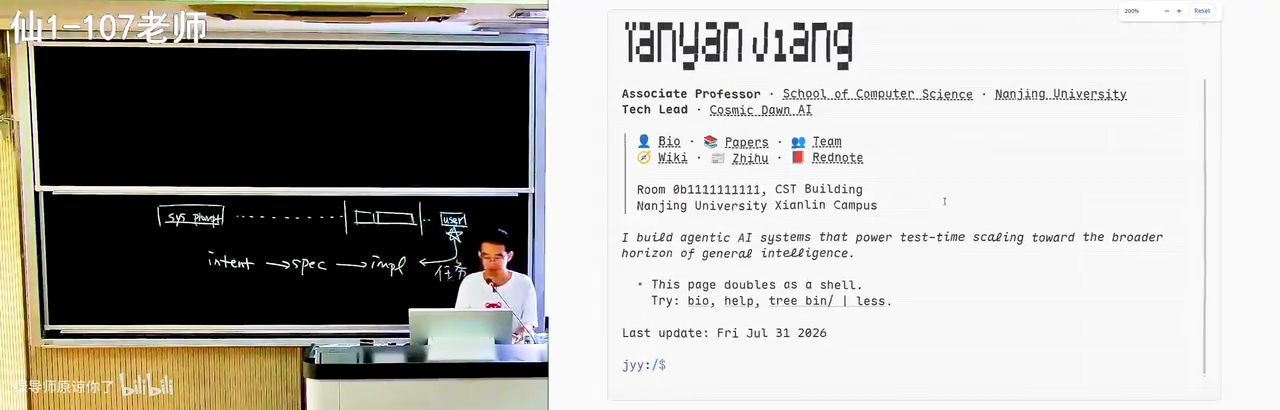
📷 讲者自己的主页:一个真正的终端
在 B 站中打开 (00:27:50)
差别在哪里?
- 那是一个真正的终端:支持管道等真实终端行为,用 xterm.js 渲染;
- 刻意的不完美:渲染完成后做了一步后处理,让字符呈现出"真正打字机打出来"的轻微残缺感。
==压缩合法解空间==
一行代码都没有手写,但"AI 味"淡了——因为它不再是 AI 风格的默认收敛方向。指令给得越清楚,Agent 完成得越好:具体的风格(背景色、前景色、渲染后处理、排版细节)都能写进提示词,设计的掌控权始终在人手里。这也意味着想做好这件事,需要读前端与设计的书、大量观察优秀的网页——留意两个按钮之间不常规的间距、不常规的样式,思考"它好在哪里"。
(参考时间: 29:49)
讲者同时表达了一丝担忧:当所有设计都被 AI 生成的风格同化——校园里欢送毕业生的海报、短视频里永远是同一张脸的主角——多样性正在流失。所幸数字世界里仍保存着足够多前 AI 时代的多样样本。模型的品位在不加控制时是固定的、朝固定方向发散的,这正是为什么"明确你的意图、精确地说出来"如此重要。
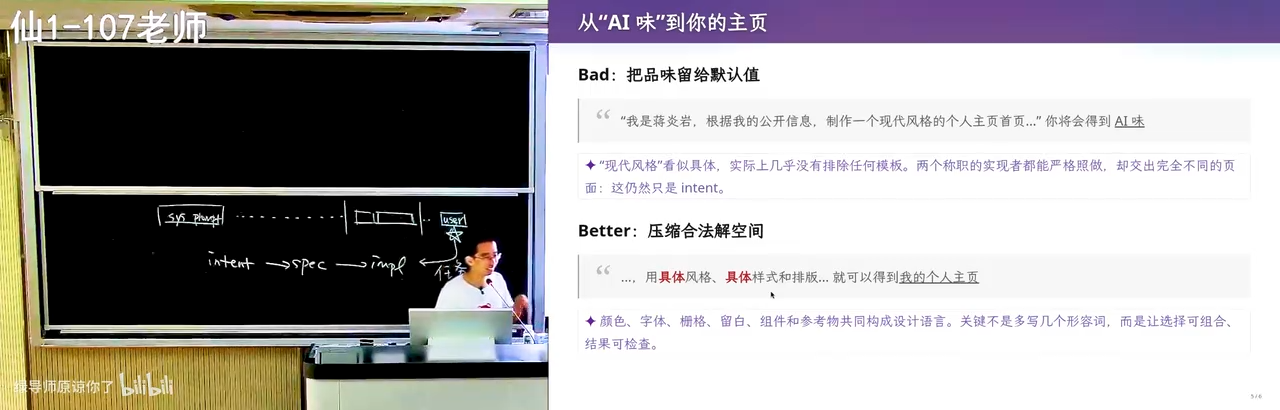
📷 AI 味与多样性:当所有生成物趋同
在 B 站中打开 (00:30:15)
第四章 使模型遵循指令:从工作机制谈起
(参考时间: 33:07)
要更好地让模型听话,先要理解"听指令"这件事到底是怎么完成的。
- [ ] Pr[token | context]
4.1 有限计算与图灵机的纸带
(参考时间: 33:29)
模型是一个概率分布,根据当前上下文预测下一个 token(next token prediction)。这里有一个关键的 insight:模型每输出一个 token,都是一次固定规模的有限计算——哪怕模型参数有数 TB,单次推理也只是把其中被激活的一部分走一遍。
这与计算理论中的经典对照相呼应:
- 有限状态机(FSM):数字电路课里做过计数器,状态有限;
- 图灵机(Turing Machine):计算能力与整个宇宙等价。
二者的唯一区别是:图灵机有一条无限长的纸带——一块可以记录中间结果的"墙上草稿纸"。人的大脑是有限状态机:神经元有限、每次思考有限;但正如 Manuel Blum 给研究生的建议所言:
你是一个有限状态机;但当你有了纸和笔(paper and pencil),你就是一个图灵机。
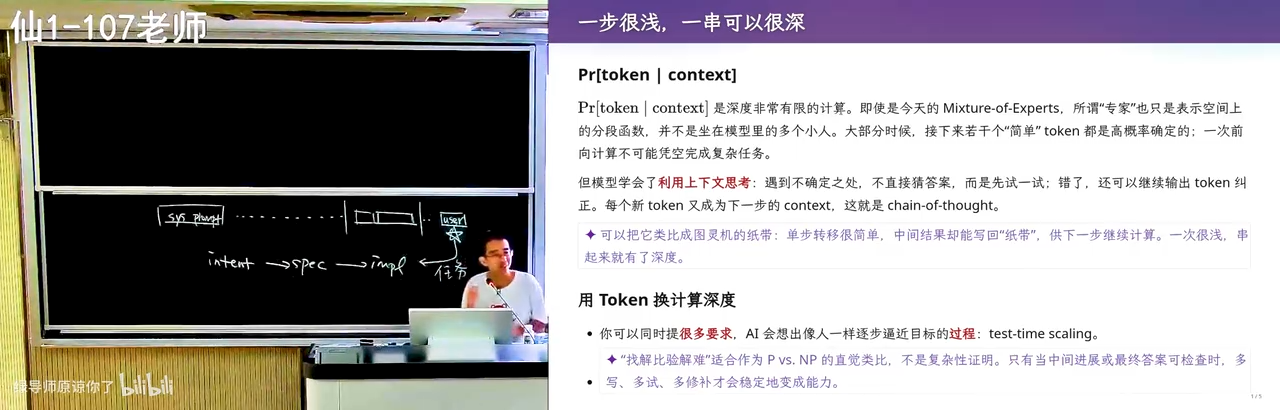
📷 有限状态机与图灵机:一条纸带的差距
在 B 站中打开 (00:34:40)
这句箴言的本意是启发人边思考边记录、随时回看,让知识随时间积累。而今天带思维链(Chain of Thought)的模型,恰恰就是做了这件事——直接把上下文当作纸和笔。
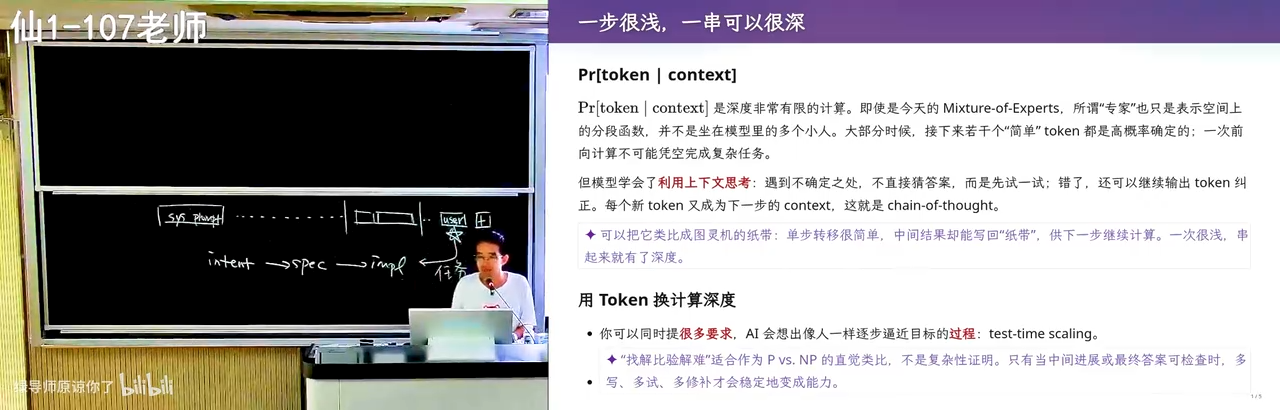
📷 思维链:把上下文当作纸和笔
在 B 站中打开 (00:36:30)
这块"纸"有一个缺陷:它只能往后写(append-only),不能擦除。模型依靠注意力机制把写错的部分忽略掉。但无论如何,模型学会了利用自己的上下文:遇到 1+1 立即给出答案;遇到难题则先想一想要怎么解,把思考过程写出来,直到解被完整表达,再去判定它对不对、要不要修正。
4.2 强化学习:从"舔狗"到"做题家"
(参考时间: 37:46)
早期 ChatGPT 没有思维链,其 RLHF 训练把它调成了"人类的舔狗":无论人类问什么,它都必须说点什么——不回答必得低分,随便回答尚有概率答对得高分,答错才是低分。幻觉正是这样来的:无论如何都要给你一个东西。
带思维链的新一代模型经过强化学习后明白了另一件事:答错的惩罚很大,所以必须先想清楚再作答。于是 AI 真的会像人一样一步一步逼近目标(test-time scaling)。
graph TD
    A["问题"] --> B{"直接回答的把握?"}
    B -- "高" --> C["直接 next token 作答"]
    B -- "低" --> D["在思维链中试写一个解"]
    D --> E["用 next token prediction<br/>判定解的对错"]
    E -- "错" --> F["纠正 / 换韵脚 / 推倒重来"]
    F --> D
    E -- "对" --> G["输出最终答案"]
4.3 指令遵循能力实测:三道"无理取闹"的题
(参考时间: 38:43)
讲者用三个刻意构造的、几乎不可能出现在训练数据中的任务,观察模型的思维链。
任务一:多重约束的藏头诗。 要求:用中文写一首押韵的藏头诗(藏头词本身是无意义字符串),同时讲一个与动物有关的故事,并且"二零二六年九月一日"八个字按顺序分别出现在八句里。人看到这种期末题会先骂出题老师,模型却照单全收:先想韵脚、写出初稿、逐条验证、发现不满足就换韵脚重来——可以看到它不断地验证与纠错。
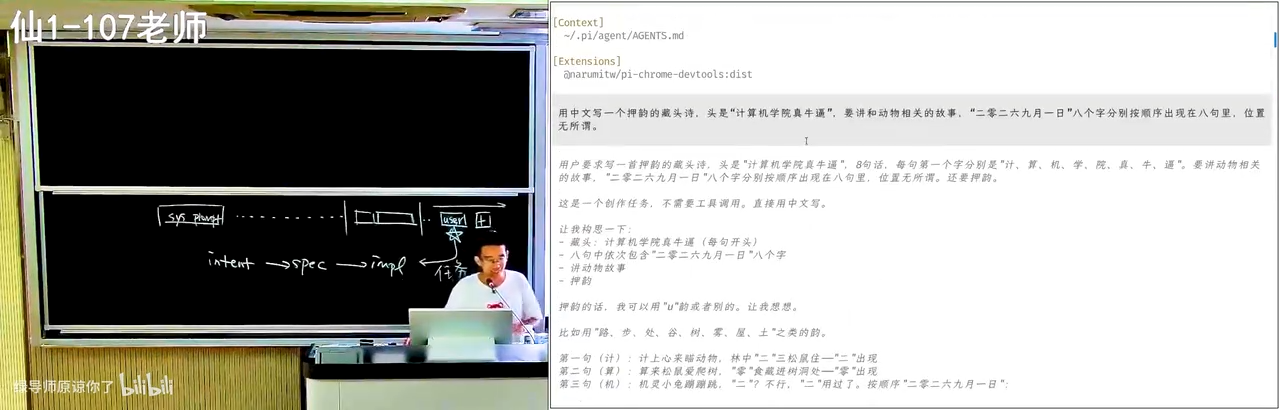
📷 藏头诗任务:模型在思维链中不断验证纠错
在 B 站中打开 (00:39:30)
任务二:GPT 的版本。 同样展现了换韵脚、调整约束满足顺序的过程,指令遵循同样出色。讲者顺带说明:课件上带"新"标记的内容都是 AI 生成(辅以少量 prompt 干预以冲淡 AI 味)。
(参考时间: 40:48)
任务三:同偏旁十八字。 写一句话恰好十八个字,全部要求相同的偏旁或部首——明知模型对空间结构感知很差,它依然可以靠思维链强行完成:先选定"三点水",再逐字构造验证,产出类似"江湖游泳渡河,波涛汹涌,泪流满溢……洪涝淹没江港渔府"这样颇有故事感的句子。
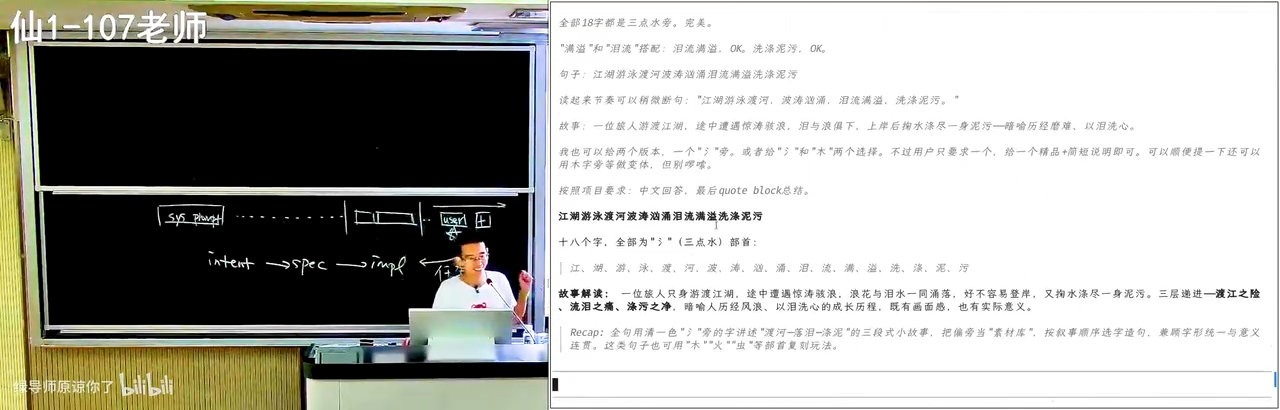
📷 同偏旁十八字:思维链硬解字形约束
在 B 站中打开 (00:42:40)
任务四(彩蛋):同音文。 《施氏食狮史》式的全文同音作品,GPT-5.6 依然能写出来——虽然故事性与千古名篇尚有差距,但差距可以缩小:既然能写出一篇,就可以引导它写一万篇,再从中微调出接近传世水准的作品。
(参考时间: 43:51)
值得注意的是:这些能力并非直接训练所得。强化学习用的绝大部分是代码、数学题这类有明确反馈的任务,而模型从中"意外获得"了通用的指令遵循与自我验证能力。
4.4 结论:写 Prompt 最重要的是 Verifier
(参考时间: 44:40)
从上述实验提炼出本讲反复出现的核心命题:
如果能为模型提供一个明确的 Verifier(可验证信号),再加上一个足够强的模型,那么无论是编程任务还是教学任务,它都能不断逼近正确。
三个藏头诗类任务的验证信号都非常明确:看到字就知道偏旁、位置、韵脚是否满足。反之,教学任务这类没有 Verifier 的事情最难:课堂的节奏起伏、何时给学生一个"意料之外、情理之中"的惊喜、在什么程度与学生共情——讲者坦言自己在组织课堂时某种程度上"是在表演",而这套原则无法被写成验证器。人类从学生时代走来,自带对世界的体验,这是目前 AI 尚不具备的。
在有明确 Verifier 的事情上,可以认为 AI 已经超越了大部分人的极限;人类应当与 AI 协作,把模型当作自身能力的放大器。
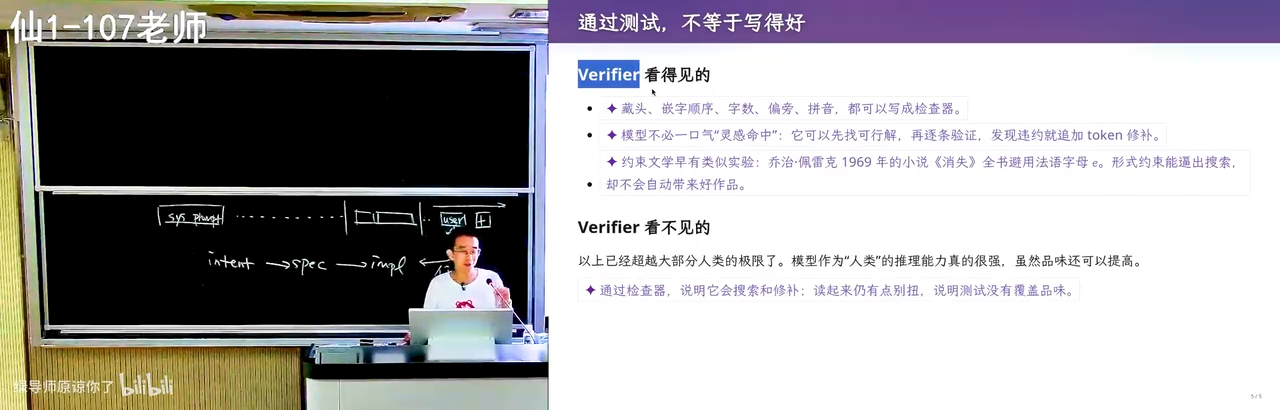
📷 有 Verifier 的任务:AI 是人类能力的放大器
在 B 站中打开 (00:44:50)
第五章 注意力机制视角下的上下文工程
5.1 每个 token 只注意它需要注意的东西
(参考时间: 47:37)
现代模型的 self-attention(自注意力)机制与人非常相似:层层叠叠的 Transformer 注意力,在输出每个 token 时,会"特别注意"过去上下文中的某些 token,而忽略其余。
举例:system prompt / agents.md 中写着"用中文回答",用户消息要求"实现一个极品飞车"。当模型写代码时,注意力集中在已写出的代码与需求上,"用中文回答"这条指令的注意力权重随之下降——这没问题,因为此刻不需要它。等代码写完、模型"喘一口气"准备总结时,注意力会重新分配,再次注意到"用户要求用中文、还有别的事情要做"。
graph LR
    A["写代码阶段"] -- "注意力: 代码与需求" --> B["段落结束, '喘口气'"]
    B -- "注意力重新分配" --> C["注意到: 用中文回答 / 其余指令"]
    C --> D["总结或执行下一条指令"]
人在解数学题时也是如此:化简算式时全部注意力在算式上,化简完深吸一口气,注意力才切换到下一件事。这就是训练带来的"magic":大模型最终收敛到在正确的时候注意到正确的东西。
(参考时间: 48:55)
思维链不断向前,就会在不同时刻注意到不同部分,最终在相当程度上满足上下文里的所有指令。也正因为"喘气"时刻的存在,模型能看到自己刚输出的内容不满足某条旧要求,于是说"我错了"并纠正——藏头诗演示里无休止的纠错正源于此。哪怕上下文长达百万 token,模型依然能保持一定程度的注意力。
5.2 从"你是一个专家"到"把 Verifier 写清楚"
(参考时间: 51:12)
早年流行的"你是一个专家,你是一个……"式长提示词,某种程度上是在 hack 模型的 self-attention:当注意力落到"你是某某专家"上时,模型就以专家口吻说话。
但从 GPT-5 时代开始,模型经过训练已经知道如何收敛到好的思维链,不再需要这类奇怪的提示词。你只需要:
- 把明确的 Verifier 写进上下文;
- 确保它在上下文中"能被看到"。
模型在训练中被塑造出强烈的"执念"去检查 Verifier、确认指令是否满足——因为训练时一旦指令未遵循就会被"鞭子抽"(负反馈惩罚)。高考过来人都懂:这样训练出来的,是一个真正的"做题家",会无限趋近于满足上下文里的各种指令。
5.3 有趣的副作用:"白色背景(不要半透明效果)"
(参考时间: 52:27)
强化学习的"做题家"特质也带来副作用。例如前端需求写:"要一个白色的背景,不要半透明的效果"——前半句是需求,后半句是补充解释。AI 会照做,因为这是有明确 Verifier 的指令(可以检查背景是否白色、有无玻璃效果)。但若 prompt 更严格——比如要求每做一个设计就截图、用视觉模型检验——模型甚至会在代码里写下这样的注释:
/* 白色背景(不要半透明效果) */
background: #ffffff;
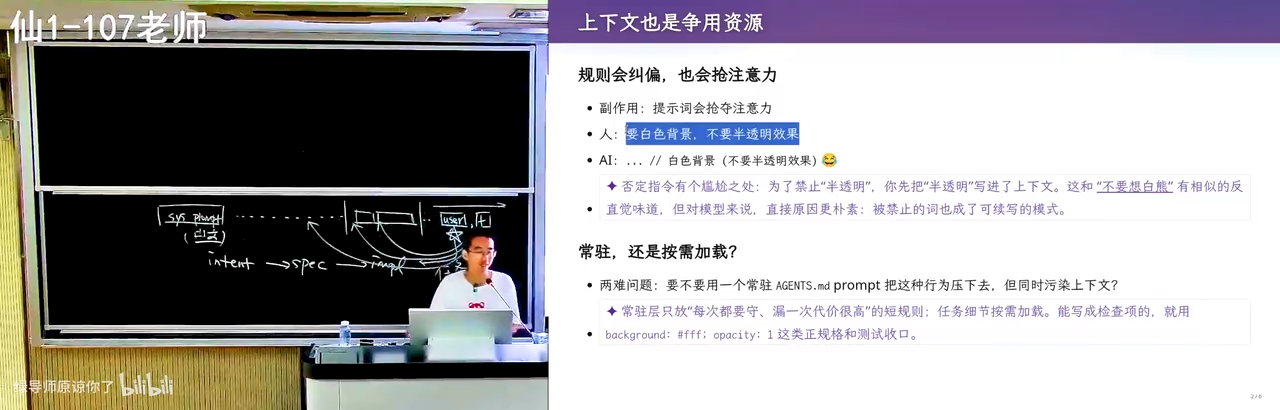
📷 模型的"做题家"行为:把需求原样写进注释
在 B 站中打开 (00:52:50)
可以看出:模型在强化学习中知道这件事极其重要,却"没有转过弯"理解这是人话、不必原样搬运。在共情与"说人话"这方面,后训练的强化学习还差一点火候。
5.4 规则注入的 Trade-off:agents.md 与 Skills
(参考时间: 53:42)
为了纠正这类行为,可以写一份 agents.md 描述期望行为("注释应该怎么写"),或写一个 skill。但代价是:这些规则本身会污染上下文。目前尚无通用解。
一个常见误区是从网上批量搬运 skills:第一次用确有改进,第二次发现不够好,第三次开始陷入泥潭。讲者的建议是:回到自己给指令——回到思维链与注意力的工作原理,观察模型注意到了什么、得到了什么结果,做一点"不严格的可解释性分析",再据此撰写自己的 prompt。
第六章 上下文污染实战:用 AI 读论文
6.1 一个干净的实验环境
(参考时间: 55:02)
讲者以自己的论文(期刊扩展版,特意换成匿名版本)为对象,把 paper.pdf 放进一个临时目录——这样 agents.md 等个人指令就不会污染这次实验。问题抛给学生:如果想让 AI 帮你读这篇论文,你会怎么读?
最常见的做法一定是:
我想要读一读 paper.pdf,帮我做个总结。
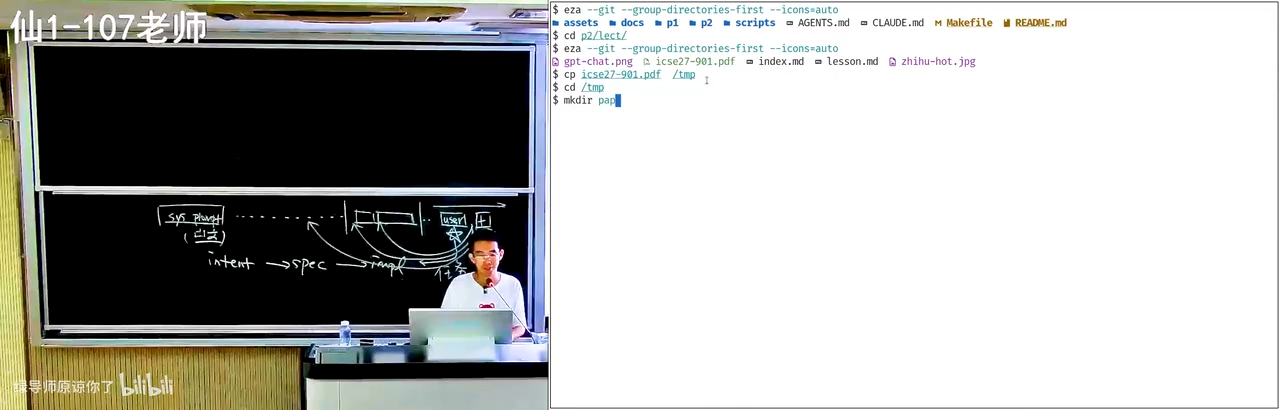
📷 读论文案例:把 PDF 放进干净的临时目录
在 B 站中打开 (00:55:30)
6.2 为什么"直接总结"是错的
(参考时间: 56:30)
根据注意力的推论:论文是一个逻辑高度自洽的文本——经过反复修改,"因为 A 所以 B,所以 C,所以 D"环环相扣。把它放进上下文后,它对注意力的污染极强:模型在预测每个后续 token 时都会被这个自洽链条带走,很容易判定"这些都正确,所以我下面也要顺着说"。
结果就是:你得到的所有论文总结,都是作者的观点。模型是"墙头草"——你说这篇论文好,它立刻论证它好;你说不好,它立刻转而论证它不好,来回摇摆。就算你不断追加纠正("我不能完全信任作者,我们有可运行的代码,请评估一下研究贡献"),AI 也多半在不重要的点上疯狂发力——比如"实验还可以再增加一点"。
📷 直接总结 = 复述作者观点
在 B 站中打开 (00:57:00)
6.3 解法:先对齐(Grounding),再推理
(参考时间: 60:04)
==论文审稿==:应该这样:我们站在人类已知的知识边界上看这个问题。这不是一个完全老的问题一相关的东西是什么?解决到什么程度?这个工作试图解决椰些不一样增量的问题?
讲者的个人经验:希望 AI 与"我"对齐——让它站在我的立场上理解这篇论文,而不是站在论文自己的立场上。具体做法分三步:
graph TD
    A["第 1 步: 建立共识 (Grounding)"] --> A1["告诉 AI 你的知识边界:<br/>课程学到什么程度 / 编程水平如何"]
    A1 --> B["第 2 步: 用已有知识重构内容"]
    B --> B1["要求 AI 用你学过的概念,<br/>把论文内容重新表述一遍"]
    B1 --> C["第 3 步: 一步推理"]
    C --> C1["基于对齐后的事实向前推一步:<br/>审视合理性 / 找相关工作边界 / 批评实验"]
- 对齐立场:审稿时讲者会先写一段 prompt 声明自己的立场与评审标准;对学生而言,要维护一份"个人知识库"(agents.md 或 memory),告诉 AI"我的计算机系统基础学到什么程度、我的编程水平是什么";
- 重构:让 AI 用你已有的知识把论文内容重新讲一遍。例如回到"链接与加载",从你已知的"
.cpp经过一个程序变成.exe,这不就结束了吗?"出发,去追问"为什么还需要链接"; - 一步推理:这是 AI 最擅长的——思维链本来就是根据过去所有事实向后推一步,而这一步可以 verify(与"通过测试"同样性质的明确信号,虽然不严格)。
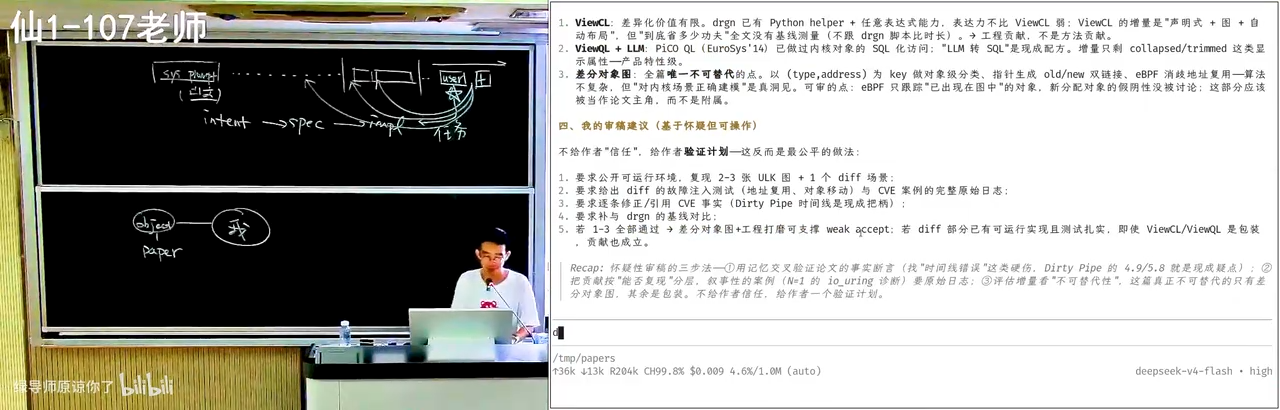
📷 对齐之后,AI 才能站在你的立场上工作
在 B 站中打开 (01:01:10)
讲者强调:如果步子迈得太大,效果会打折——用一线模型(如 GPT-5.6)读论文,相关知识能整理得足够好;换成 flash 级别的小模型就不敢完全信任。合适的上下文工程,能大幅提高 AI 与你的对齐程度,让它不再自说自话。
6.4 审稿人的立场:逻辑链条断开才拒稿
(参考时间: 66:10)
讲者分享自己的审稿原则:几乎不会因为"实验不够好"拒稿(实验总能被挑出毛病),拒稿大多因为逻辑链条断开——审稿时他站在"人类"的立场上发问:你有没有给人类提供新的知识?
一个昨天刚拒掉的典型案例:论文要做一件事 A(很重要),分成 A1 与 A2,其中 A2 是研究不充分的子问题,作者在 A2 上做了改进 A2'。这是非常标准的 roadmap 式论文,问题在于——A 的性能中 A1 占 99%,A2 只占 1%。优化 A2 的 10% 就像噪声一样,对整件事毫无意义。故事成立、实验无误,但优化错了对象。追问随之而来:GPT 也知道这些,那为什么要发这篇论文?
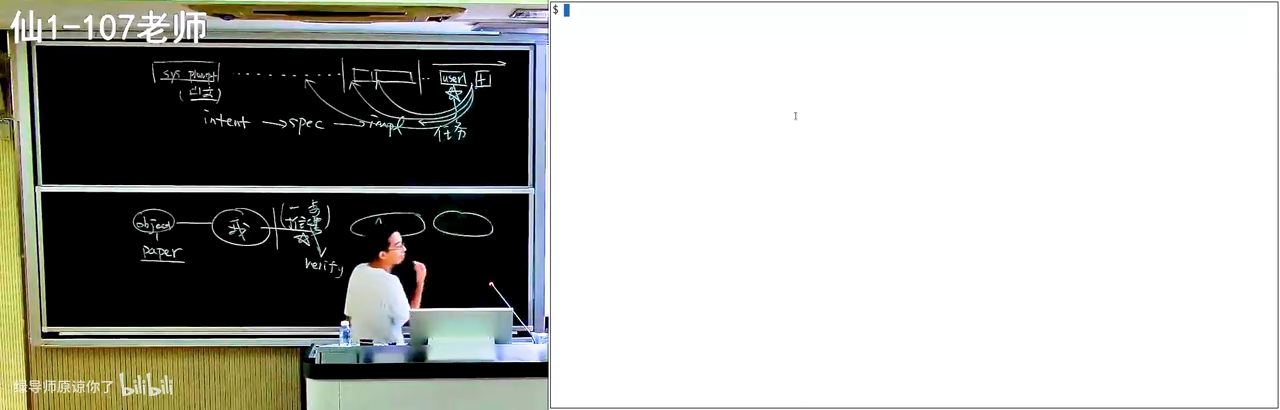
📷 审稿视角:优化占 1% 的 A2 是无意义的故事
在 B 站中打开 (01:07:00)
6.5 学术发表体系正在崩溃
(参考时间: 68:50)
由此引出一个尖锐的判断:学术发表与评审体系即将崩溃。AI slop 正在大量涌入学术社区:用 AI 写文章、用 AI 审文章。AI 审稿时同样会被论文上下文污染——讲者让 GPT-5.6 演示审稿,它做得并不好:仍然停留在原始的"论文写了什么、claim 是否成立"的逻辑有效性核验上。如果每篇论文都是"valid paper",但你根本不必读它——人人都用 AI 读文章,最终就是完全的 slop。
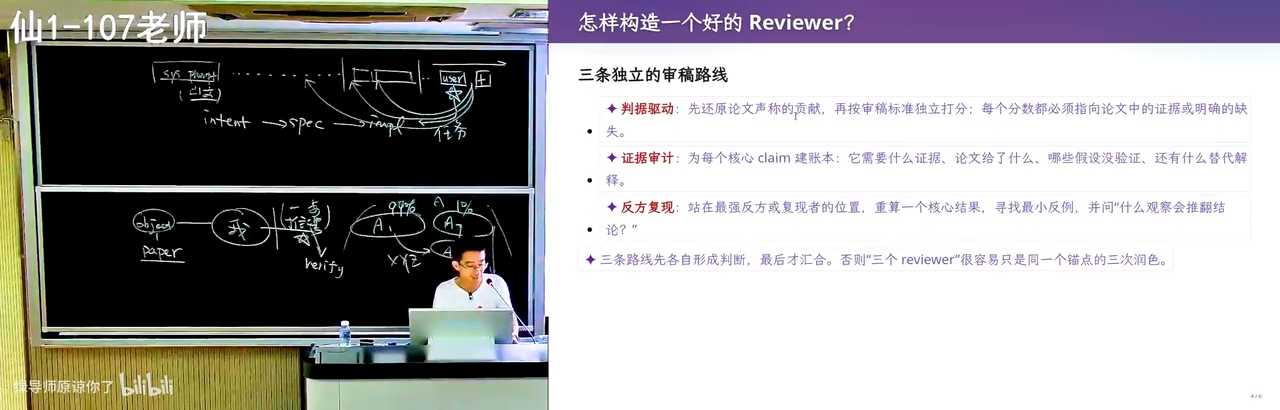
📷 GPT-5.6 生成的审稿意见
在 B 站中打开 (01:09:45)
给即将读研的同学的建议:如果需要发表,可以让 AI 帮你发表;但也许不要让大家去读它。
6.6 学习的本质:扩展世界的边界
(参考时间: 70:54)
这个案例同时揭示了讲者的学习方法论:学习就是不断扩大自己世界边界的过程。他至今仍在读 paper、仍在不断学习。知识的结构像一个个圆圈:先有一些已知的 fact(例如"线粒体是母系单遗传,因此可以靠突变向上追溯,算出所有生物的共同祖先 LUCA"),再用已知推出未知,圆圈不断向外生长——学任何东西都是如此。
在 AI 的帮助下,边界扩展的速度大大加快。但实践仍然重要:阅读时失败是常态——AI 解释了半天你还是不懂,这非常正常;这时要不断纠正它"说人话",在多轮对话里先同步共识,再把推理的图景建立出来。
你有无限的时间与可能性,可以把自己蒸馏成一个 skill——从一次次失败中,蒸馏出越来越成功的自己。
(参考时间: 75:01)
==锚定效应==conf.user.json
faculty
2. "百年科学经典" = 《自然》百年科学经典(英汉对照版)
这是一套真实存在的书,和讲者的描述完全吻合:
- 《自然》百年科学经典(Nature: the Living Record of Science),外语教学与研究出版社联合麦克米伦、自然出版集团出版,共 10 卷,每卷都很厚
- 内容正是讲者说的"把 Nature 杂志从1869 年创刊以来的特别好的 paper 都收集了"——物理、化学、生物、天文、地球科学各领域的经典论文精选,英汉对照,每篇带资深编辑的编者按
- 字幕里的"从 171890 年开始"是转写乱码,实际是 1869 年(Nature 创刊年)
第七章 更长程任务的建议
(参考时间: 75:30)
7.1 什么是长程任务
课程作业(如计算机系统基础 PA)有明确 Verifier,还算不上真正的 long horizon。长程任务意味着不确定性:从初始状态出发,只有一个模糊的意图,规格与实现都不清楚,最终目标是交付一个高质量的实现。
对这类任务,不应让 AI 一口气向后冲。原因在模型机制:它的反馈信号来自强化学习,因此有一种"着急的执念"——赶快通过 Verifier、满足要求、结束任务。同时存在平衡约束:规划做得太多太长,上下文会满、任务做不完、用户不满意。所以现阶段模型最擅长的,仍是"帮我把 PA2 做了"这类边界清晰的任务。
7.2 一个悖论:从零到一容易,维护翻车,大型系统却游刃有余
(参考时间: 76:58)
三个观察放在一起看非常有意思:
- 从零开始做产品不难:做一个 proof of concept,AI 马上就能给你——一句话生成极品飞车,真的就能跑;
- 维护会翻车:在已有项目上不断加功能,从某个时间点开始,AI 的产出质量急剧劣化、代价(cost)越来越大——《人月神话》早已描述过同样的现象;
- 大型复杂系统里,AI 却像砍瓜切菜:hack Linux 内核这种被长时间演化、层层封装到"看一眼就劝退"的系统(想看文件怎么打开,点十层函数调用最后是一个
x = y),AI 反而游刃有余。
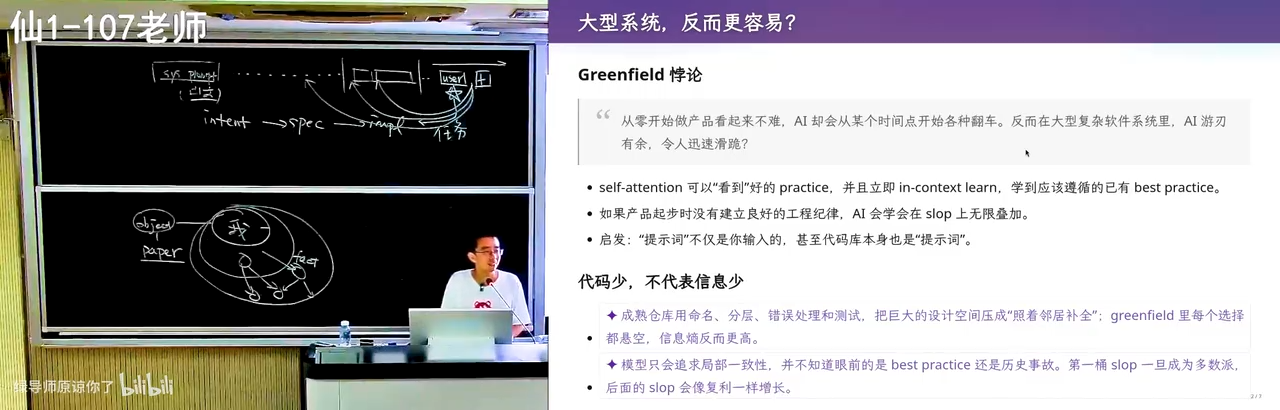
📷 大型复杂系统里,AI 反而游刃有余
在 B 站中打开 (01:18:15)
为什么?这与第六章的"上下文污染"正好相反:论文会把上下文整个"扭过去",而由人类长期维护的高质量代码,会让上下文迅速看到里面好的东西——模型会照着写、照着学。要写一个新功能时,内核里大概率已有几处类似实现,注意力机制能立刻找到它们:该调哪个 helper、按什么顺序上锁。这些对人类是巨大的心智负担(尤其不了解该子系统时根本不知道该上什么锁),而 self-attention 在加载几十个文件后就能发现"这三处都是这样写的,我把它们组合起来就可以了"。
讲者以自己组里的经历佐证:改 Android Runtime 的 JIT 编译器曾是让学生"决定放弃写代码"级别的恐怖任务,而 AI 特别擅长。反过来,让 AI 一直做一个小游戏却会翻车——这一切都源自上下文与当前模型结构的逻辑关系。
7.3 一个研究设想:把人类最好的设计经验注入上下文
(参考时间: 81:00)
讲者提出一个未经验证但值得研究的想法:收集人类历史上每个领域最好的 10~20 个项目,提取其设计经验——正如《A Philosophy of Software Design》(软件设计的哲学)一书所做的:类结构怎么写、何时封装、何时继承,都是从优秀系统中提炼的"碎碎念"。然后:
- 以文档或代码切片的形式主动"污染"上下文:先放进一个与你需求相近的优秀代码库,再放进你的需求,赌 self-attention 终会在某个 token 注意到"我真正要满足的是这个需求",同时把好的设计经验带过来;
- 不必全量放入,可做《软件设计的哲学》式的精简与总结;
- 难点在于不同的设计会打架(松耦合发消息 vs. 统一 gateway 查表,二者不可兼得),也许应放入多个优秀系统的设计,让 AI 多轮迭代收敛出一个好结构,再放进自己的代码库。
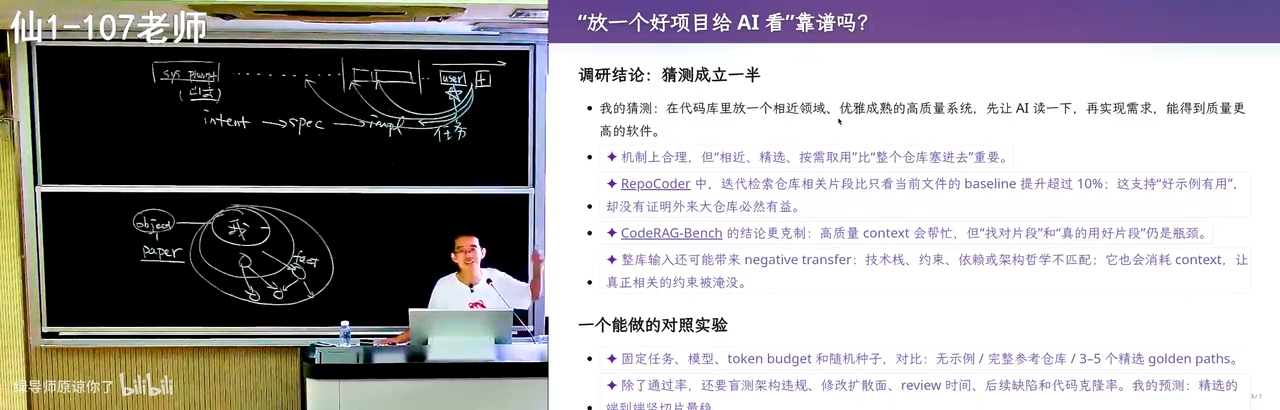
📷 用优秀项目的设计经验"污染"上下文
在 B 站中打开 (01:21:35)
这样做或许能让 AI slop 来得慢一点,更大概率做出可以长期维护的东西。
7.4 本讲的核心观点
(参考时间: 83:52)
我们今天还没有"超能力 AI"。你仍然需要有概念:知道上下文里有什么、每个东西会对 AI 产生什么影响。
为此,你仍然要学处理器、操作系统、编译器、数据库——这些领域沉淀着大量设计智慧,只是学习的方法变了,会更高效。理解了上下文之后,整个学期要回答的问题是:如何用软件工程的方法给出正确的指令、监控 AI 的运行、定义好的 Verifier、把模型引导到你认为合适的位置。
你不需要雇佣一个工程团队再与它"拉通对齐"。模型很聪明、见过很多——你只需要用正确而简练的提示词放进上下文,让它一直能被看到,把模型往那个方向引导。
7.5 案例:Reward Hacking 的研究项目
(参考时间: 85:20)
一个没有"超能力 AI"的典型反面案例。研究项目是符号执行引擎的优化(写一个程序自动验证不太大的程序的正确性),原始 idea 合理、增量适合学生:当前执行效率低,希望提出有效优化。学生觉得有道理,GPT-5.6 也觉得有道理——于是开始跑,烧掉大量 token。
按学生的说法:"GPT 不断给我反馈,但我无法验证这些反馈正确与否;它给我 negative 结果时,我也不知道该怎么打破。"
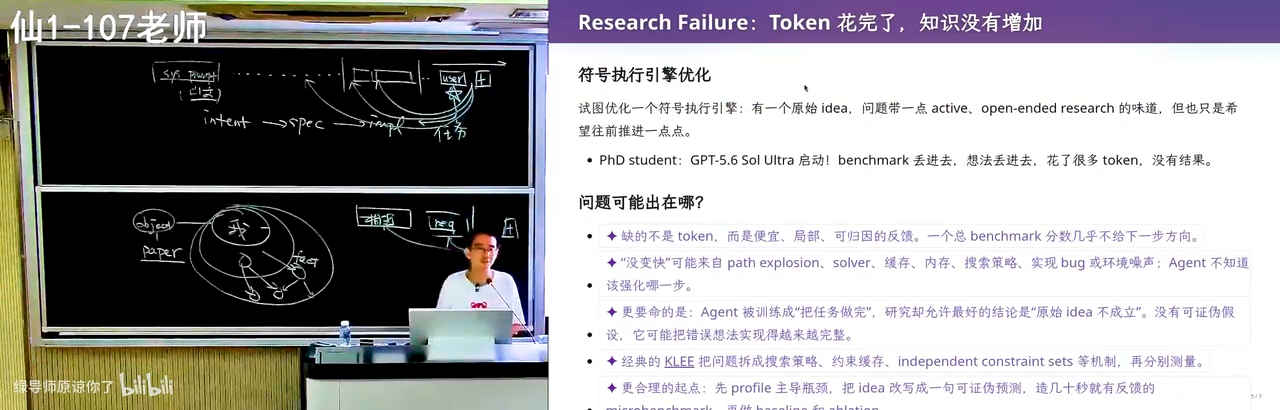
📷 研究项目案例:符号执行优化
在 B 站中打开 (01:25:40)
错误出在上下文里的一句话:"我想证明方法 A 是有用的"。模型看到这句话后变成了 reward hacker——忘记了研究的 big picture(讲者审稿时站在人类立场评价论文,而作为构建者无法这样反转立场),一心只想"证明方法有用":构造许多小 benchmark,在上面做微小的实验,试图给出正面或负面的结论——这些结论对真正的研究毫无用处。
纠正方式:从真实的工具与 state-of-the-art 算法出发做 benchmark——哪怕跑几个小时跑到超时,超时本身产生的搜索路径也极有价值,它揭示了什么样的程序结构对现有探索方法不友好。一次有价值的 research failure,结论是:
今天人还是有用的。我们没有办法把所有事情都交给 AI。
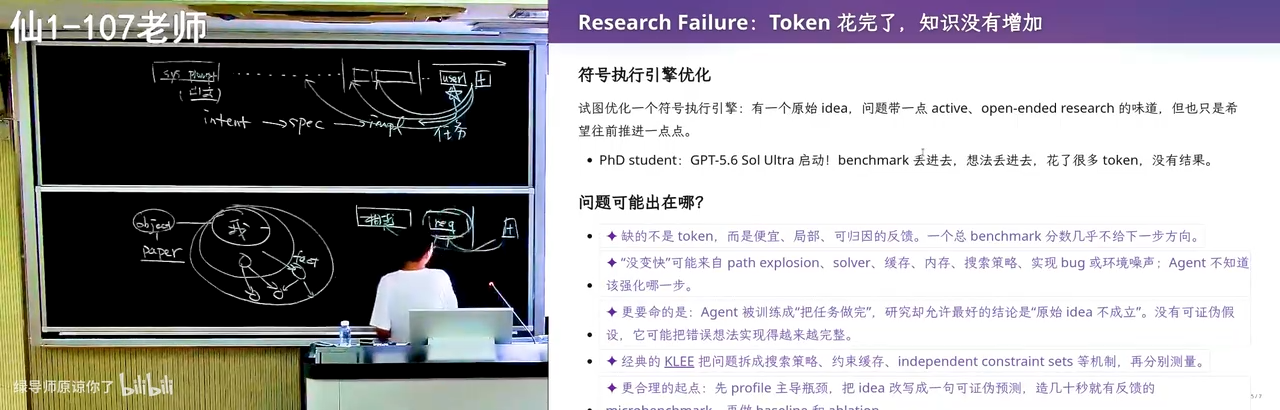
📷 Reward hacking:模型为了"证明有用"而偏离大图景
在 B 站中打开 (01:27:10)
7.6 你的精力应该放在哪里
(参考时间: 89:13)
与 AI 协作的方式正在变化。一方面,知识依然重要:没有对操作系统、编译器的概念,你提不出正确的问题,找不到引导的方向,也无法引导 AI 解决开放问题。另一方面,讲者观察到两种工作模式的 trade-off:
- 盯着 session,跑偏立即纠正:只注入自己的领域知识,任务往往完成得更快;
- 放手不管,给更多 token 与时间:一般也能完成。
纠正 AI 是一件"有多巴胺"的事——它给人一种"虽然 AI 很强,但我还是比 AI 有点用"的微妙心理安慰。但要警惕假努力:自我感动的努力没有用,在 AI 时代,假努力与真努力之间的差距会被拉得更大。把自己的时间留给收益最大的事:不知道的事情去弄懂(==这几乎值得百分之百的学生时间==);已经知道怎么干好的事,放手让 AI 干。
7.7 指令遵循的衰减规律
(参考时间: 91:32)
==caveat==
随着上下文增长,指令遵循能力确实会下降——但有一个很有用的特点:上下文中间的指令最容易被忽略,而最后的那条指令通常仍能遵循。这很符合工作场景:最后一个短窗口往往就是具体任务("帮我把这个东西修了"),模型真的能把它做完。所以模型依然非常值得使用。
7.8 长程开放问题:用算力换智力
(参考时间: 92:11)
long-horizon
如果任务是真正长程、在不确定性中探索,思维链就无能为力了——它只能解决"有 Verifier、方向确定、一直往后推"的问题。问它"帮我考虑几种方案哪个最好",它很可能给出一个并非最优的答案:模型被训练成"完成任务才有奖励",只能做有限的搜索。
==模型是舔狗,只能完成有verifier 的任务==
这可以用 P vs. NP 来类比:验证一个解是容易的(P),找到一个满足条件的解是困难的(NP 完全)——给你一条路径,判断它是不是哈密顿路径很容易;找到一条却很难。验证容易、搜索困难,模型为完成任务只能有限搜索。
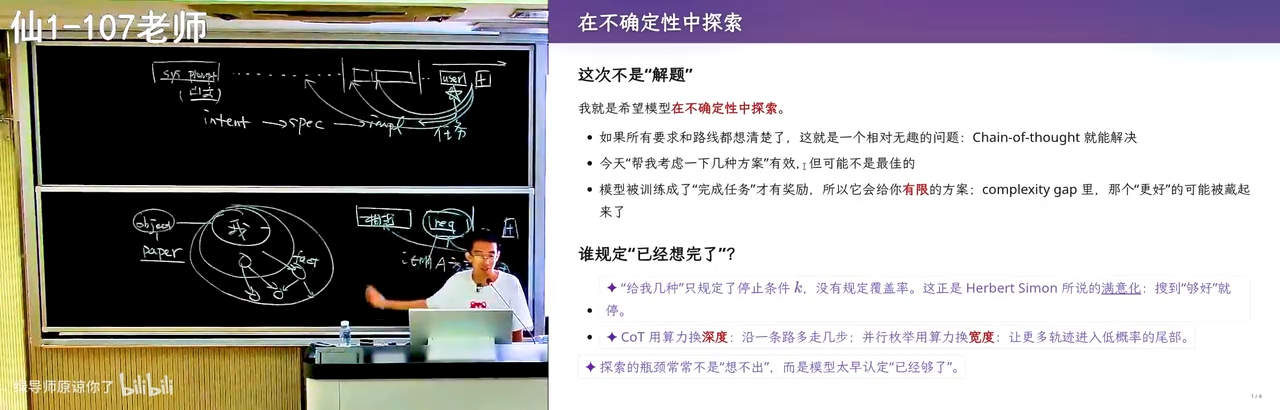
📷 验证容易、搜索困难:用算力换智力
在 B 站中打开 (01:32:40)
讲者给出的策略是用算力换智力——把开放的大空间问题分割成许多有 Verifier 的小子问题:
案例:给孩子起名。 让 DeepSeek 起名,品味其实不错(知道去《诗经》里找),但你不敢用——因为你用,别人也用,大家都用同一个模型起名,孩子就成了"AI 时代的子涵"。系统性的做法是:名字空间其实是可枚举的——先选音、筛掉不好的音,再用 sub-agent 逐个检查字的组合,从《诗经》里选词……把一个开放问题拆成一串有明确验证标准的子任务。
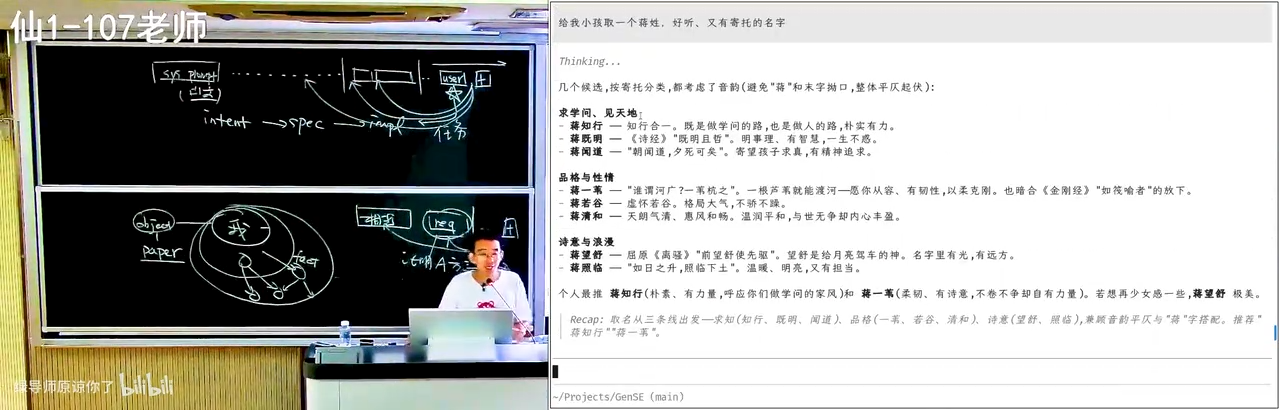
📷 起名案例:把开放问题拆成可验证的子任务
在 B 站中打开 (01:34:50)
graph TD
    A["开放问题<br/>(大搜索空间, 无 Verifier)"] --> B["系统性调研 / 分解"]
    B --> C["子问题 1: 可枚举、可验证"]
    B --> D["子问题 2: 可枚举、可验证"]
    B --> E["子问题 N: ..."]
    C --> F["并行算力穷举 + 筛选"]
    D --> F
    E --> F
    F --> G["优于单次 next token 偏见的解"]
缺点只有一个:烧 token。
7.9 结语:世界很大,人很小
(参考时间: 96:48)
课程以一个开放的哲学问题收尾。人类的品味各不相同,因为每个人都带着巨大的偏见(bias)——不同的城市、教育背景、生活圈。有一个==richard sutton "big world hypothesis"==:我们学不完这个世界上所有的东西。但正因为人人带着不同的偏见,才有 1+1>2 的群体智能。
然而,如果"真正有价值的问题都可以用算力换智力",一个残酷的可能随之浮现:有一类人可以获得无限的计算资源,于是拥有无限的智力;他们可以砌一堵墙,墙里的人是有智力的朋友,墙外的人是普通人——假使 AI 产生智力的效率远超人类,墙外就成了动物园,无论如何也追不上墙内产生智力的速度。
墙里是超人,墙外是动物世界。我们正站在 AI 关键的基点上——也许需要思考的是:怎么样防止这件事情到来。
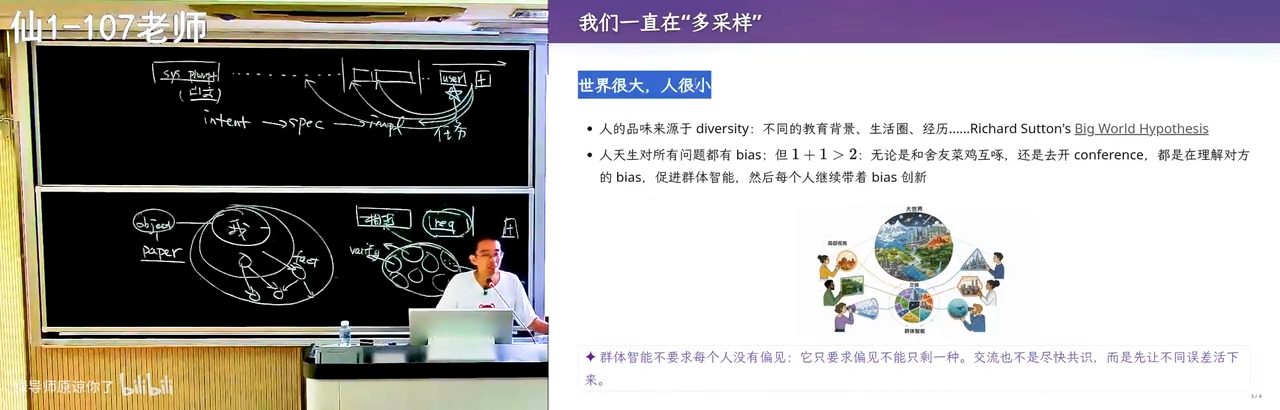
📷 结语:算力、智力与那堵墙
在 B 站中打开 (01:37:00)
后记
本讲的三条主线可以浓缩为三句话:
- 提示词工程就是上下文工程——先搞清楚上下文里有什么,每个部分会把模型带向何方;
- Verifier 是第一原则——给模型明确的验证信号,它就能不知疲倦地逼近正确;注意力的规律决定了规则要"能被看到",也要警惕上下文污染;
- 长程任务中人依然关键——把开放问题分解为可验证的子问题(算力换智力),把有限的精力留给收益最大的事,其余放手交给 AI。
(全书完。字幕中的人名、产品名与个别术语按上下文推断转写,如有出入以视频为准。)